激活函数
Tanh
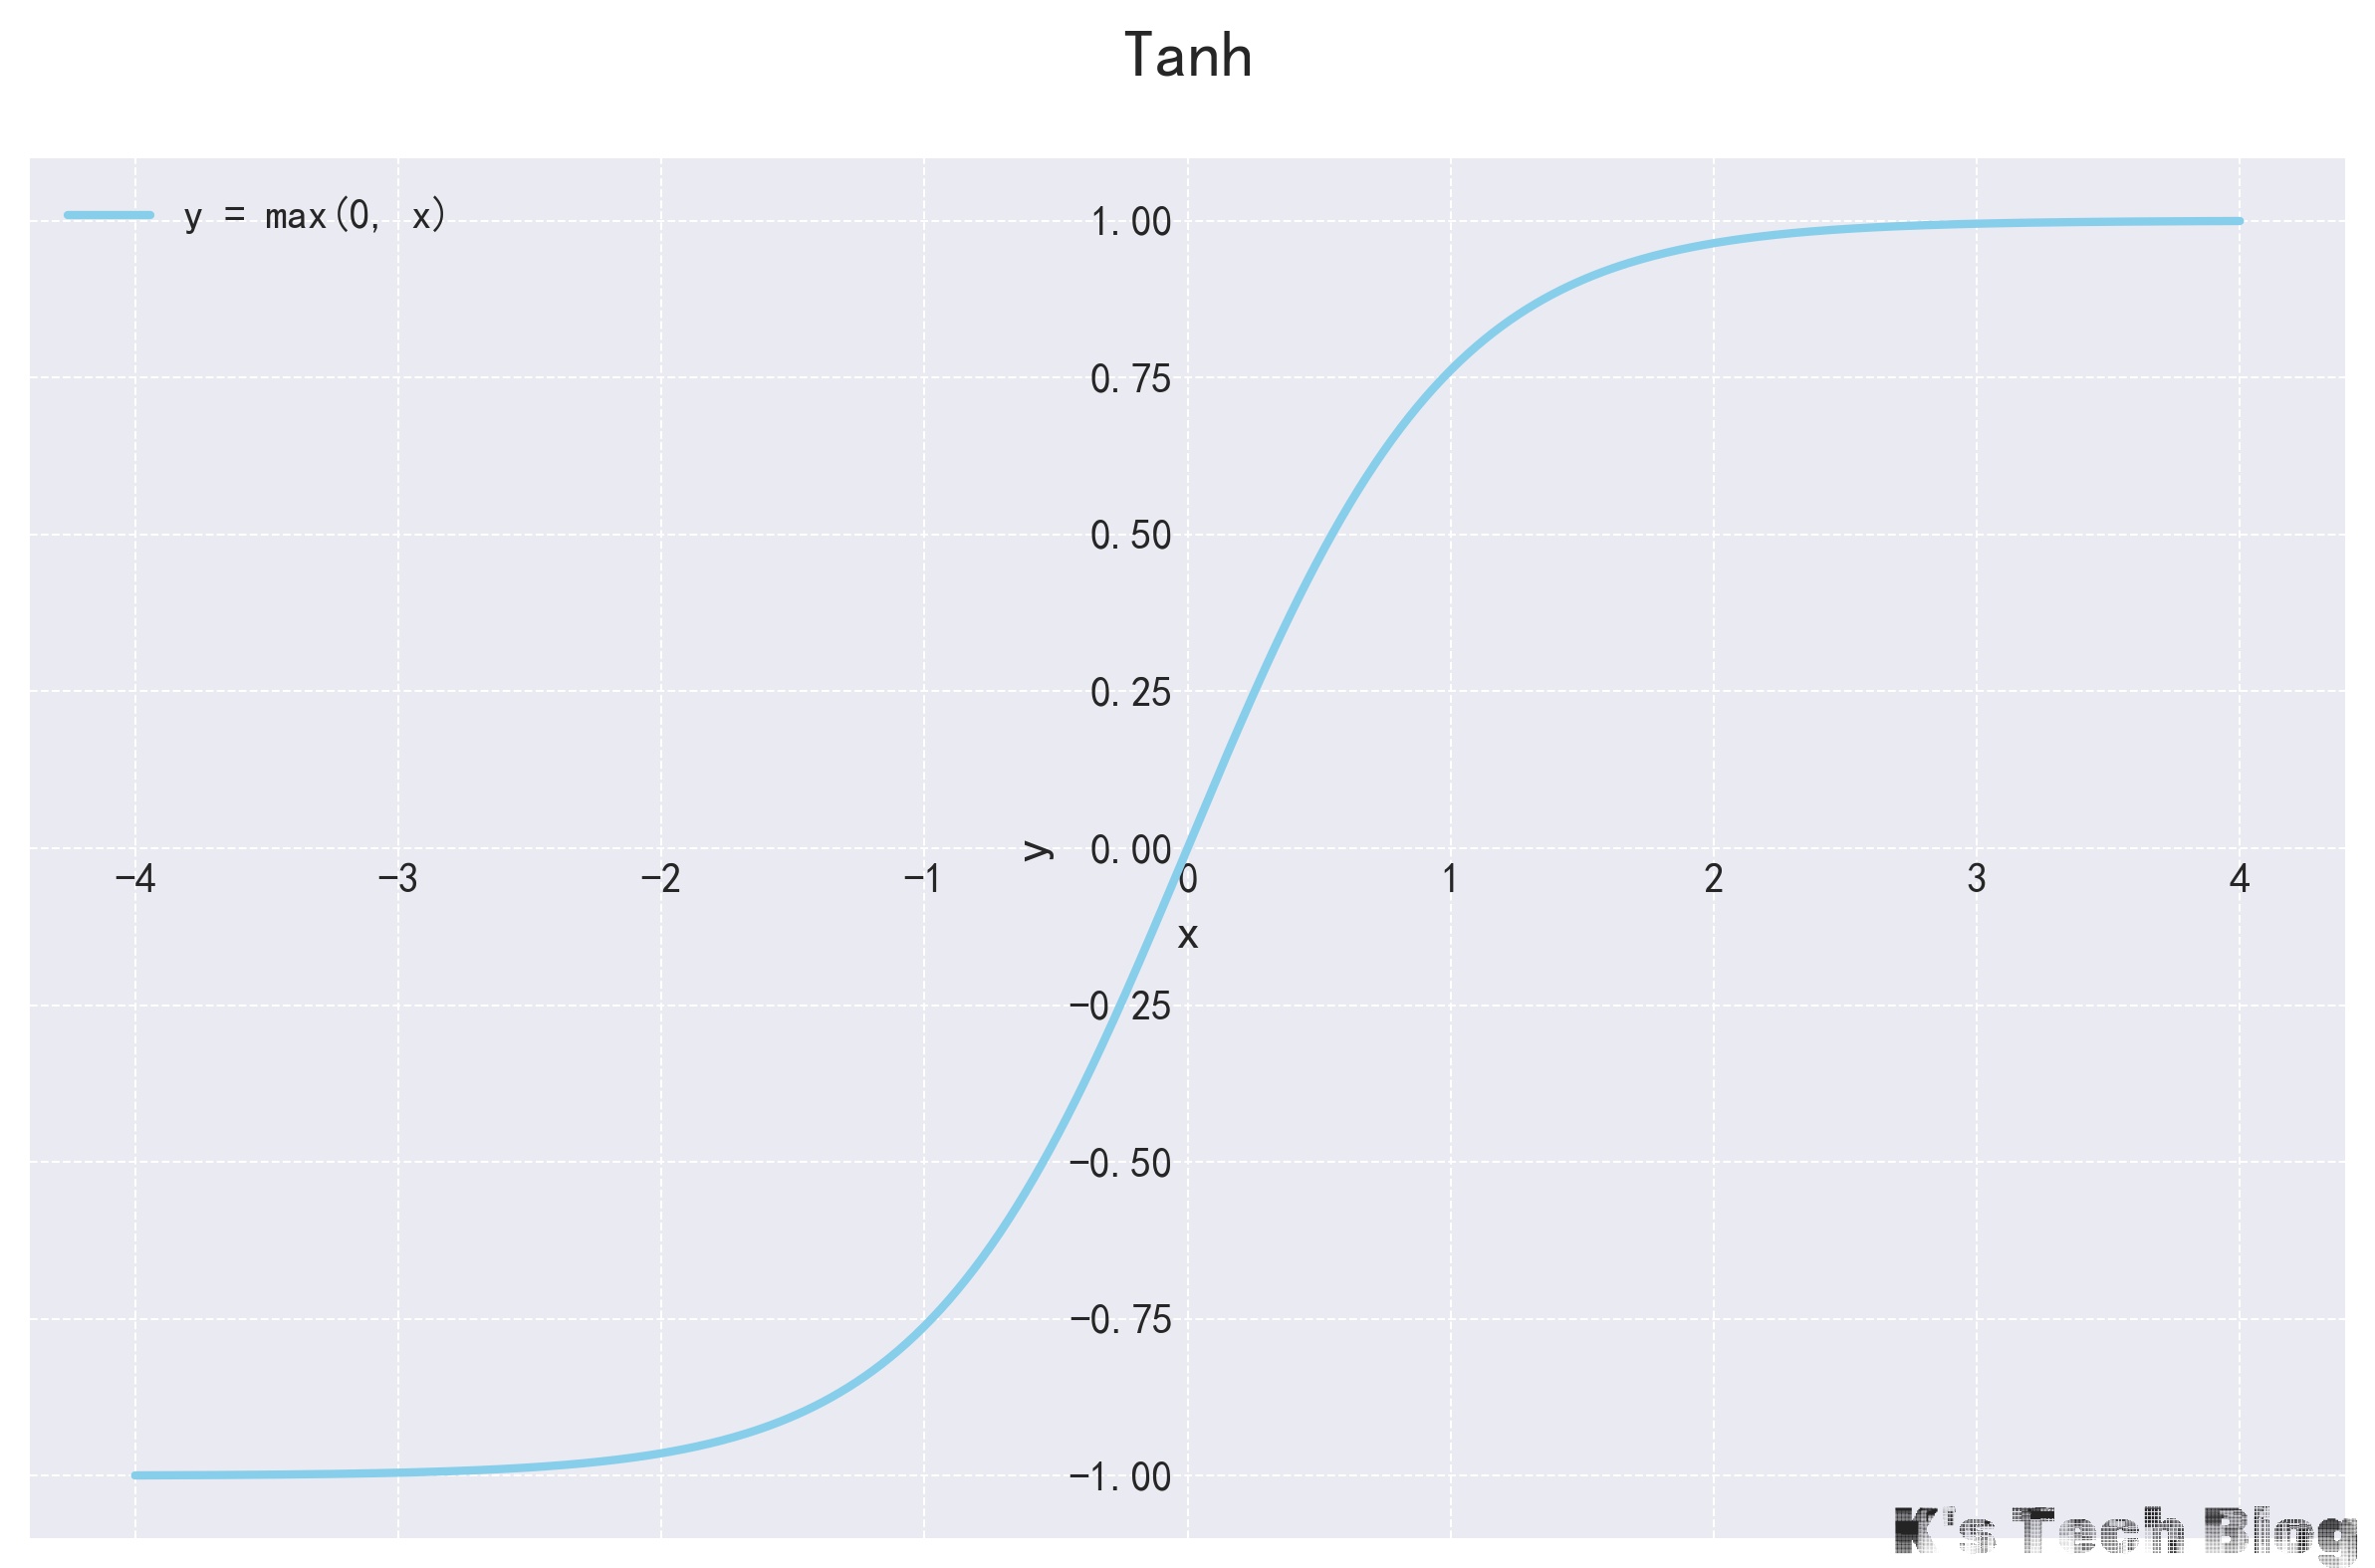
- Tanh(Tangent hyperbolic):双曲正切函数 $$ Tanh(x) = \frac{e^{x} - e^{-x}}{e^{x} + e^{-x}} $$
Sigmoid
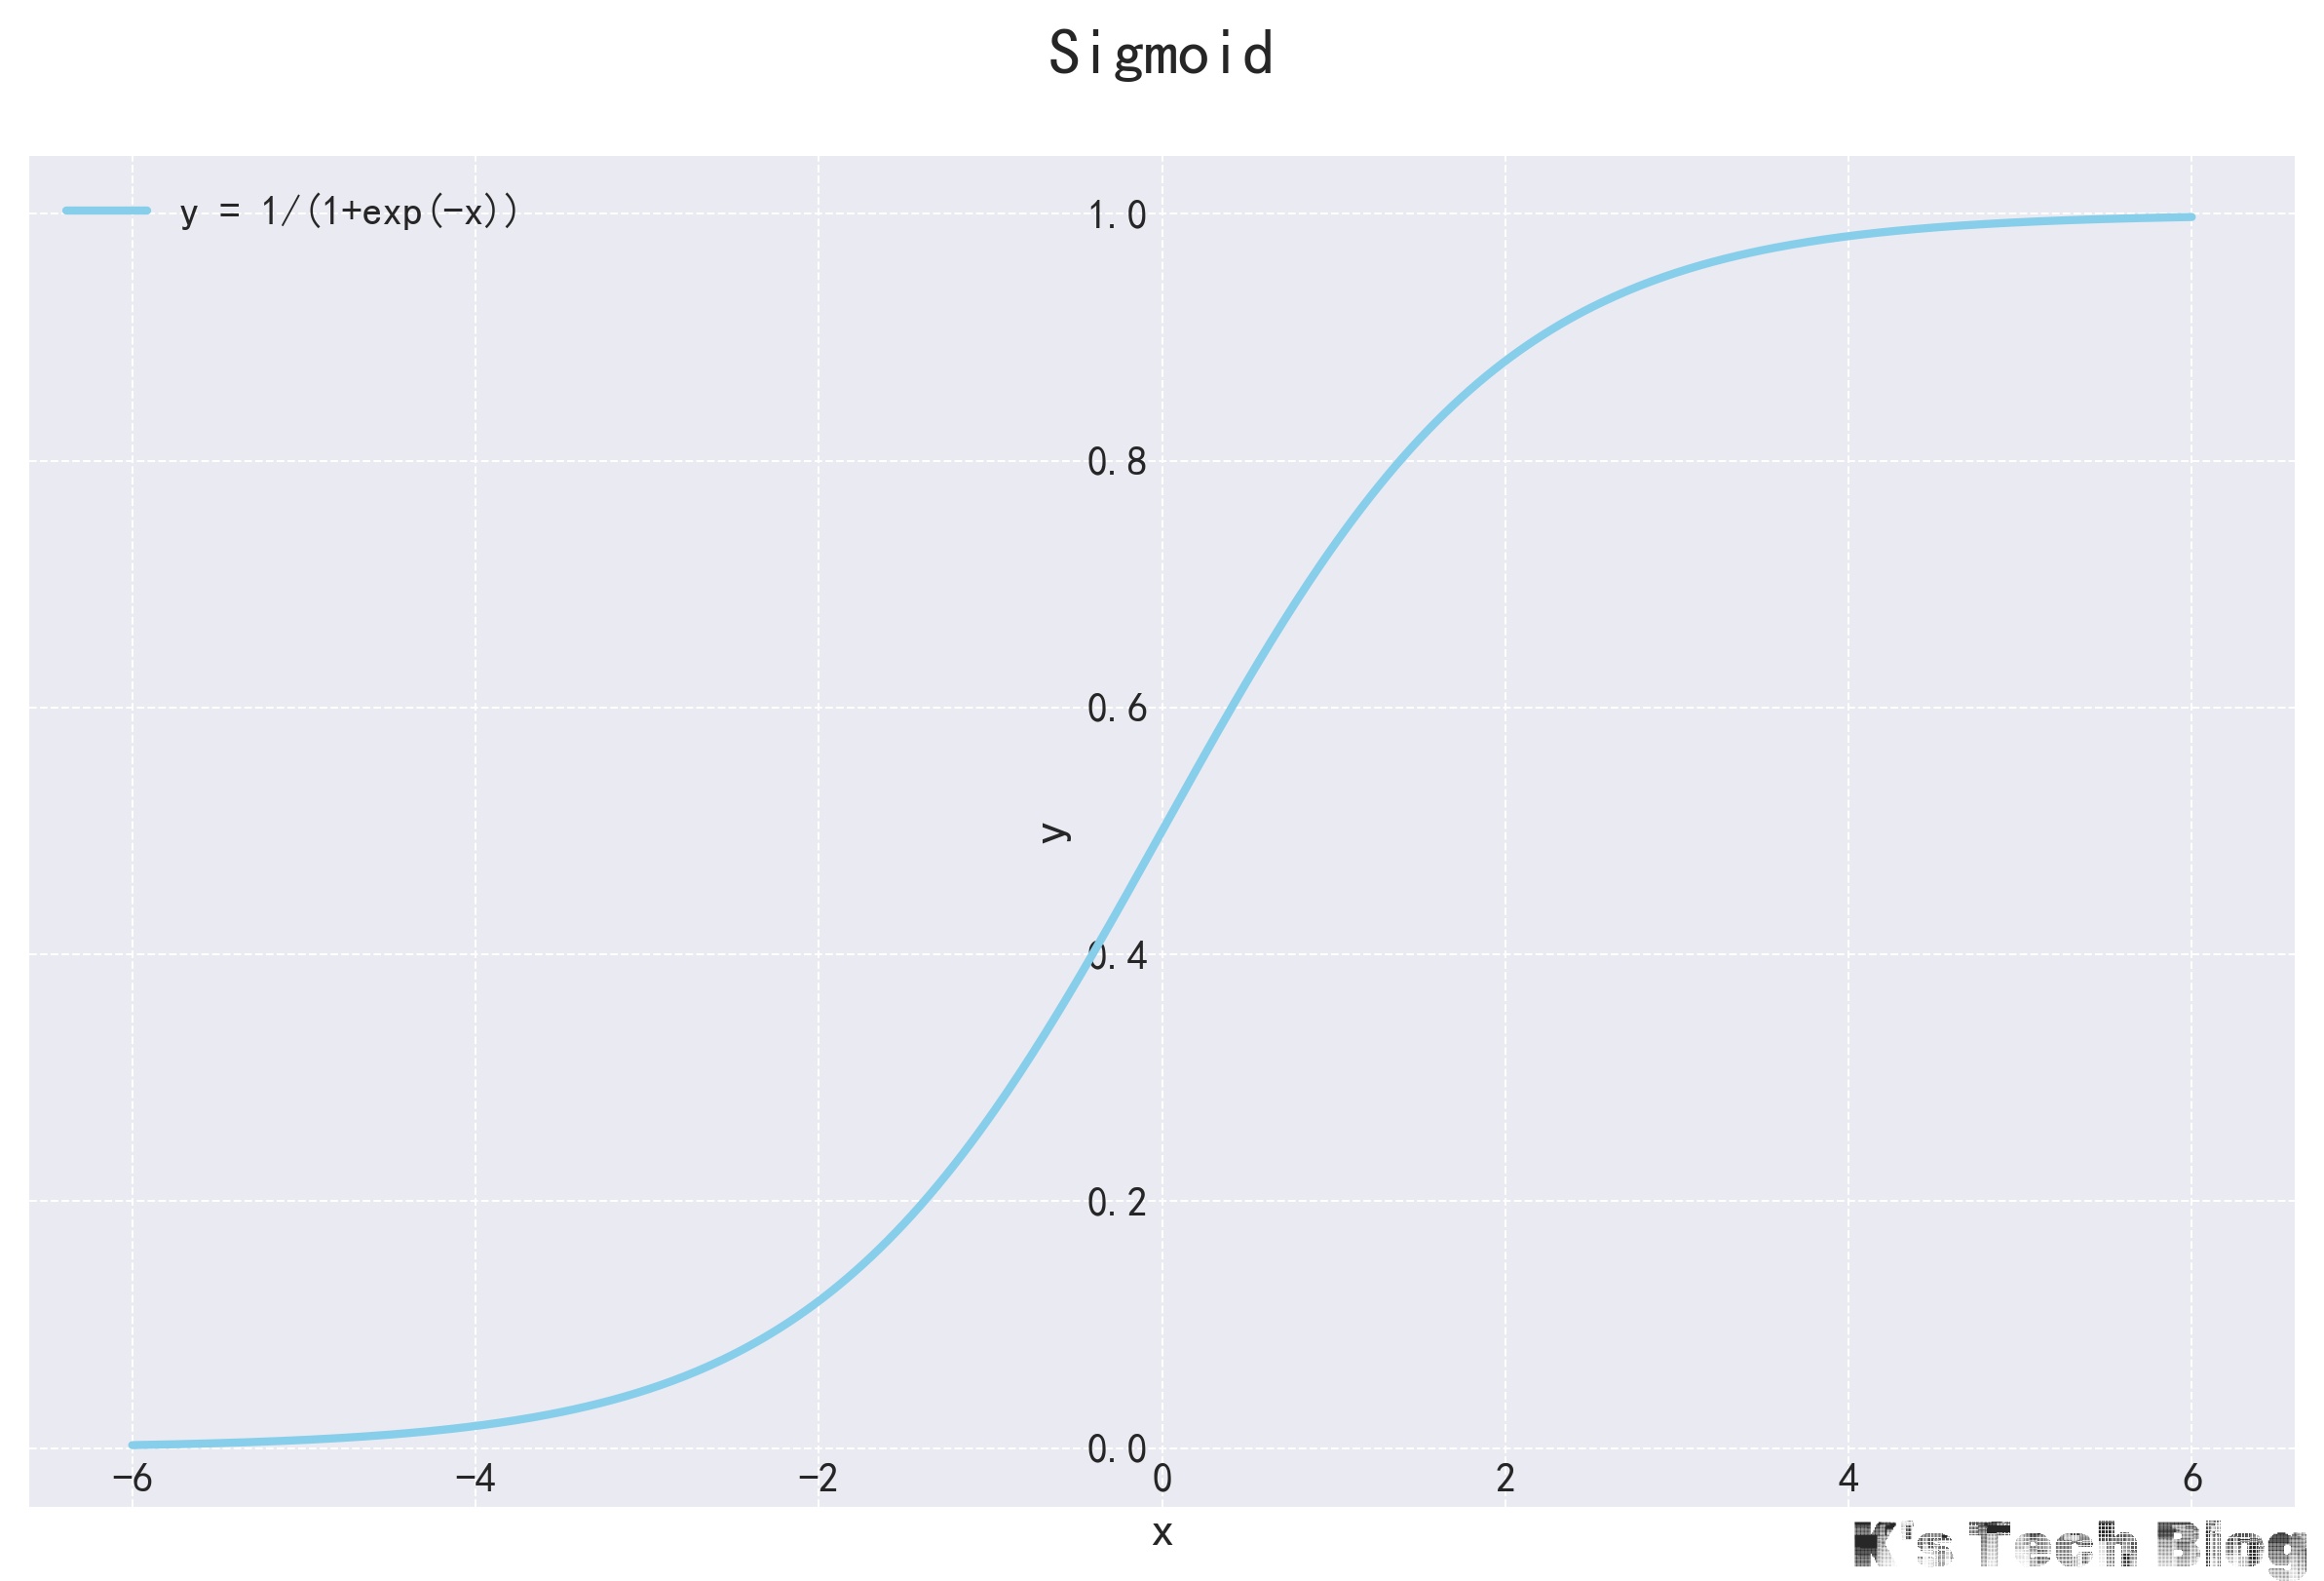
Sigmoid函数,也称为Logistic函数,是一个非常经典的“S”型函数。他的主要作用是将任何实数输入映射到(0, 1)这个开区间内。
- 主要作用:二元分类输出层;早期的神经网络隐藏层。
- 缺点:
- 计算成本高。
- 输出非零中心。
- 梯度消失:$x$极大和极小的时候,梯度接近于0;且每层梯度小的情况下,梯度反向传播越乘越小,最后接近于0(梯度小时),导致优化困难,后面被ReLU系列激活函数替代。
LeakyReLU
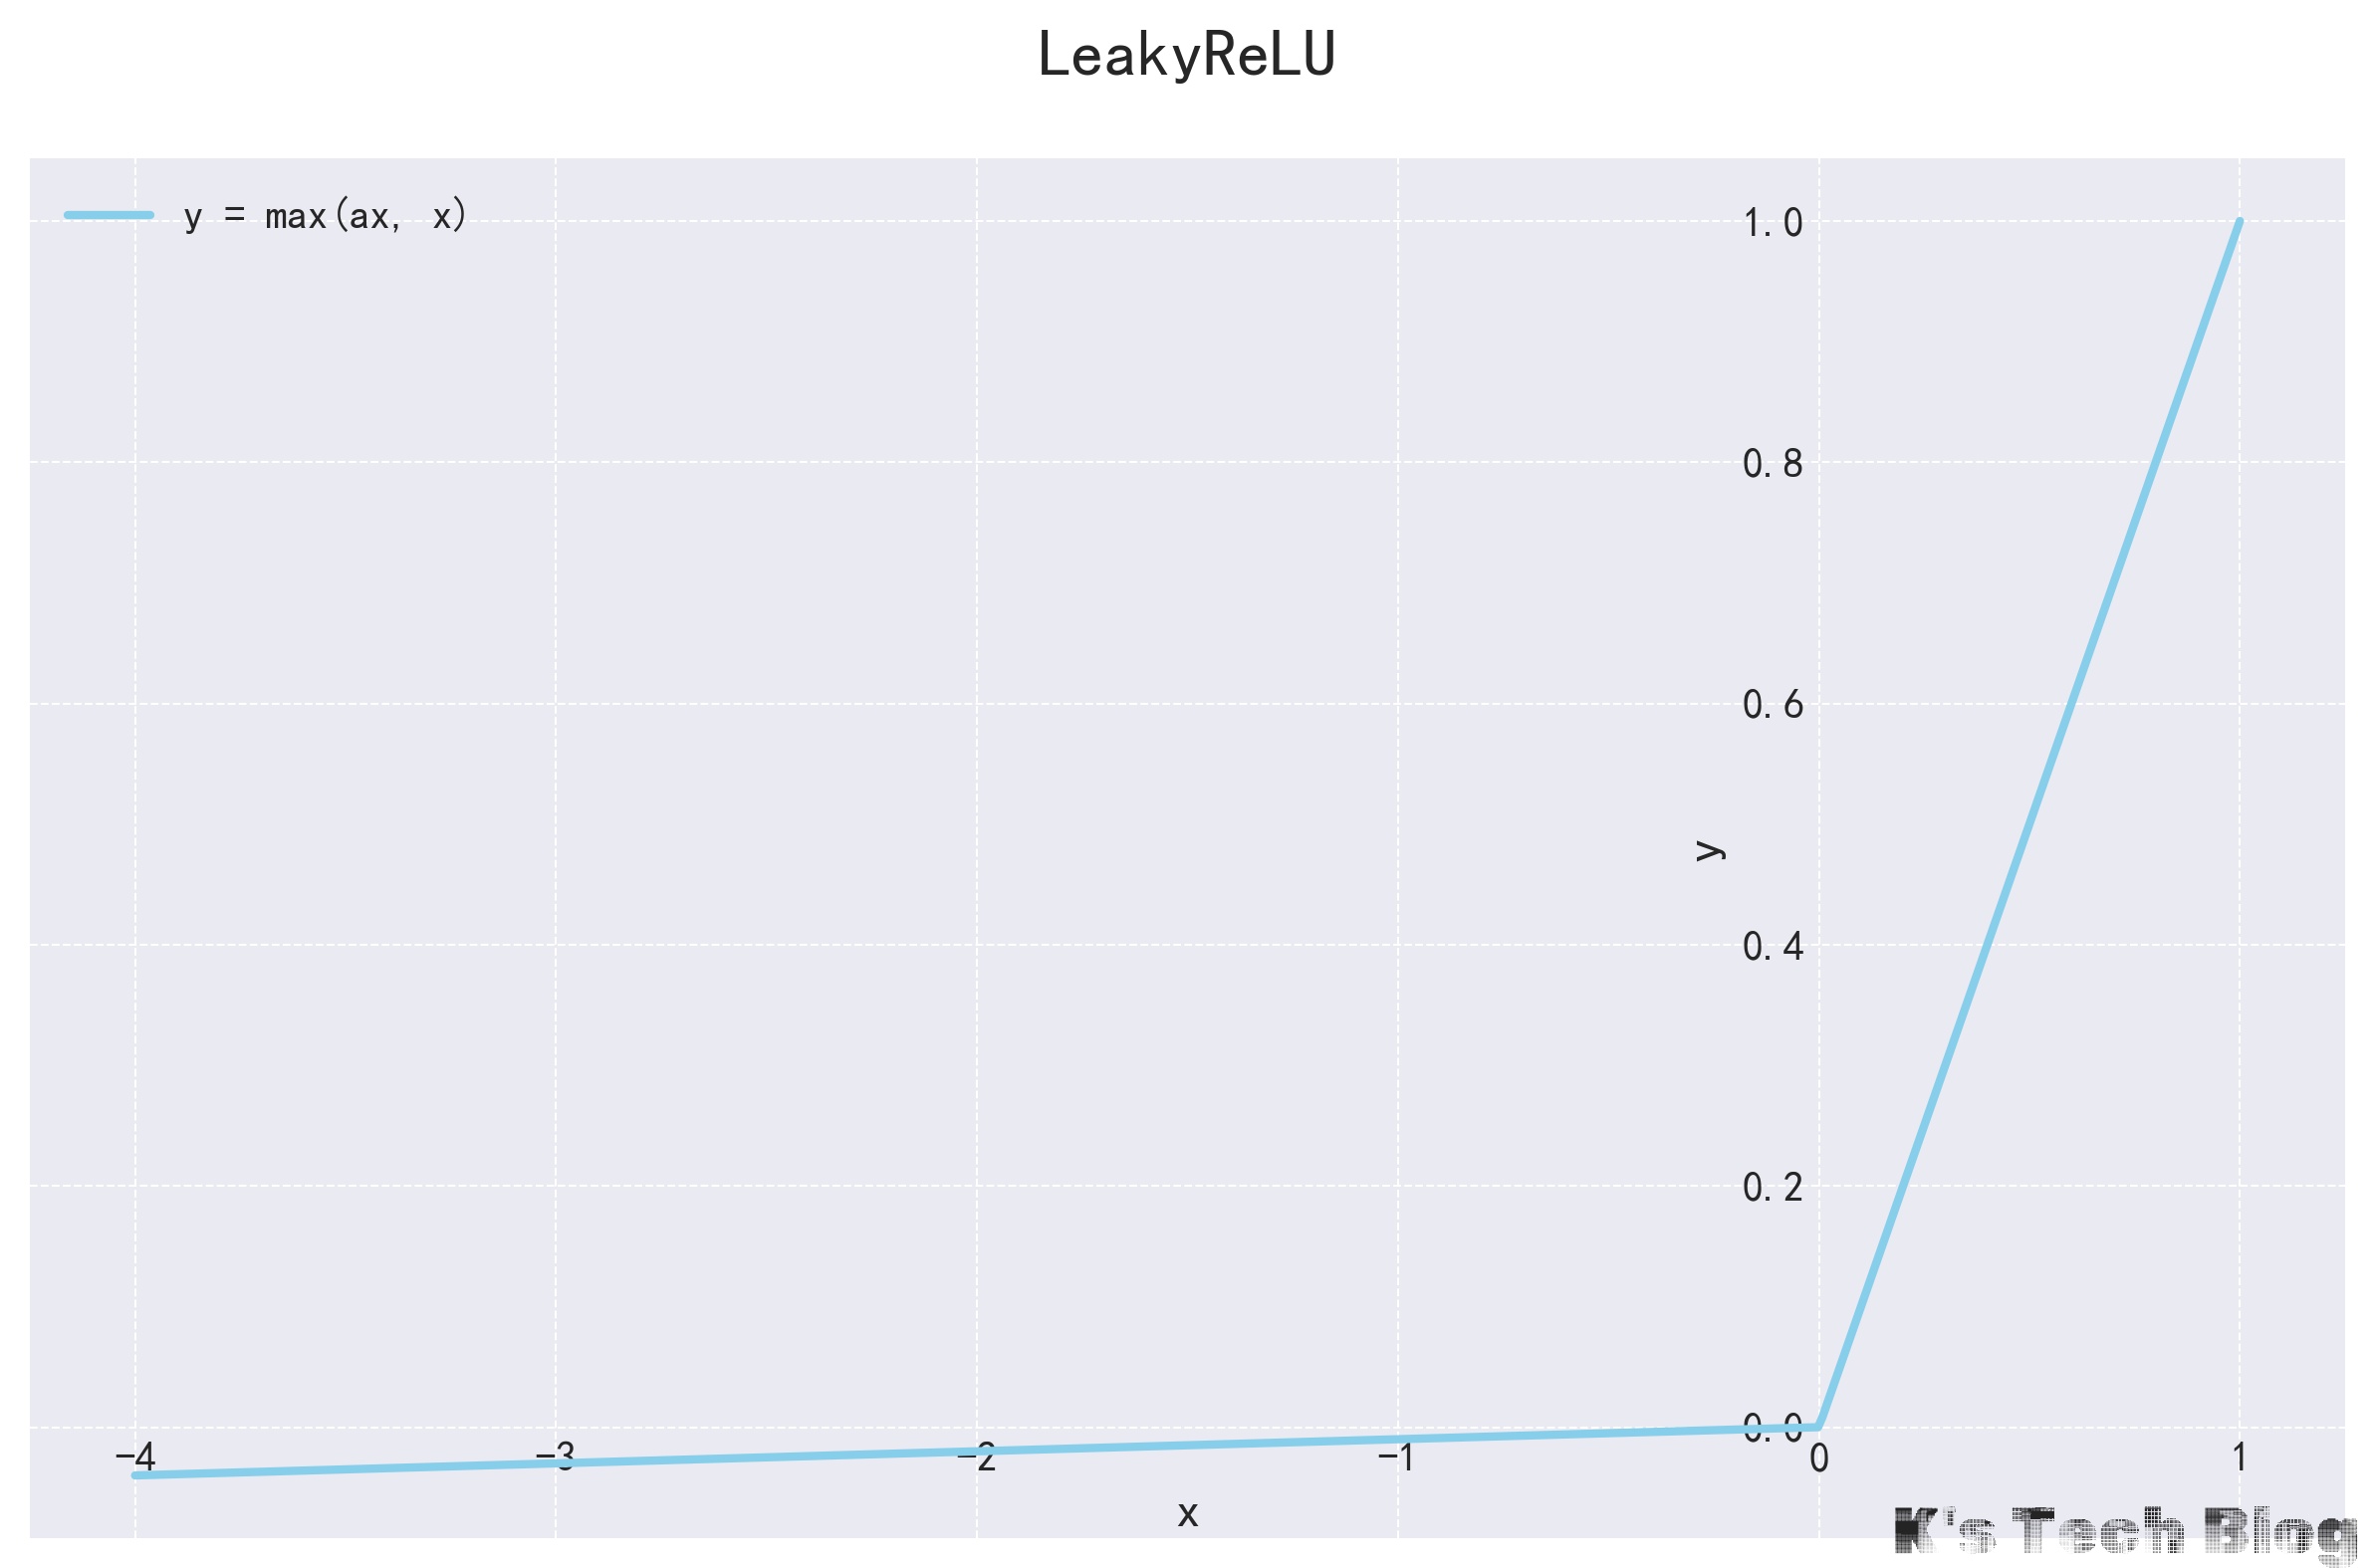
LeakyRelu,全称为“带泄露的修正线性单元”,是经典激活函数ReLU(Rectified Linear Unit)的一个改进版本。- 核心思想是:输入值为负的时候,不再像ReLU那样直接输出0,而是输出一个非常小的、非零的、固定的整数。
- $a$被成为“泄露系数”,通常取值为
0.01,也可以根据需求设置为其他值。
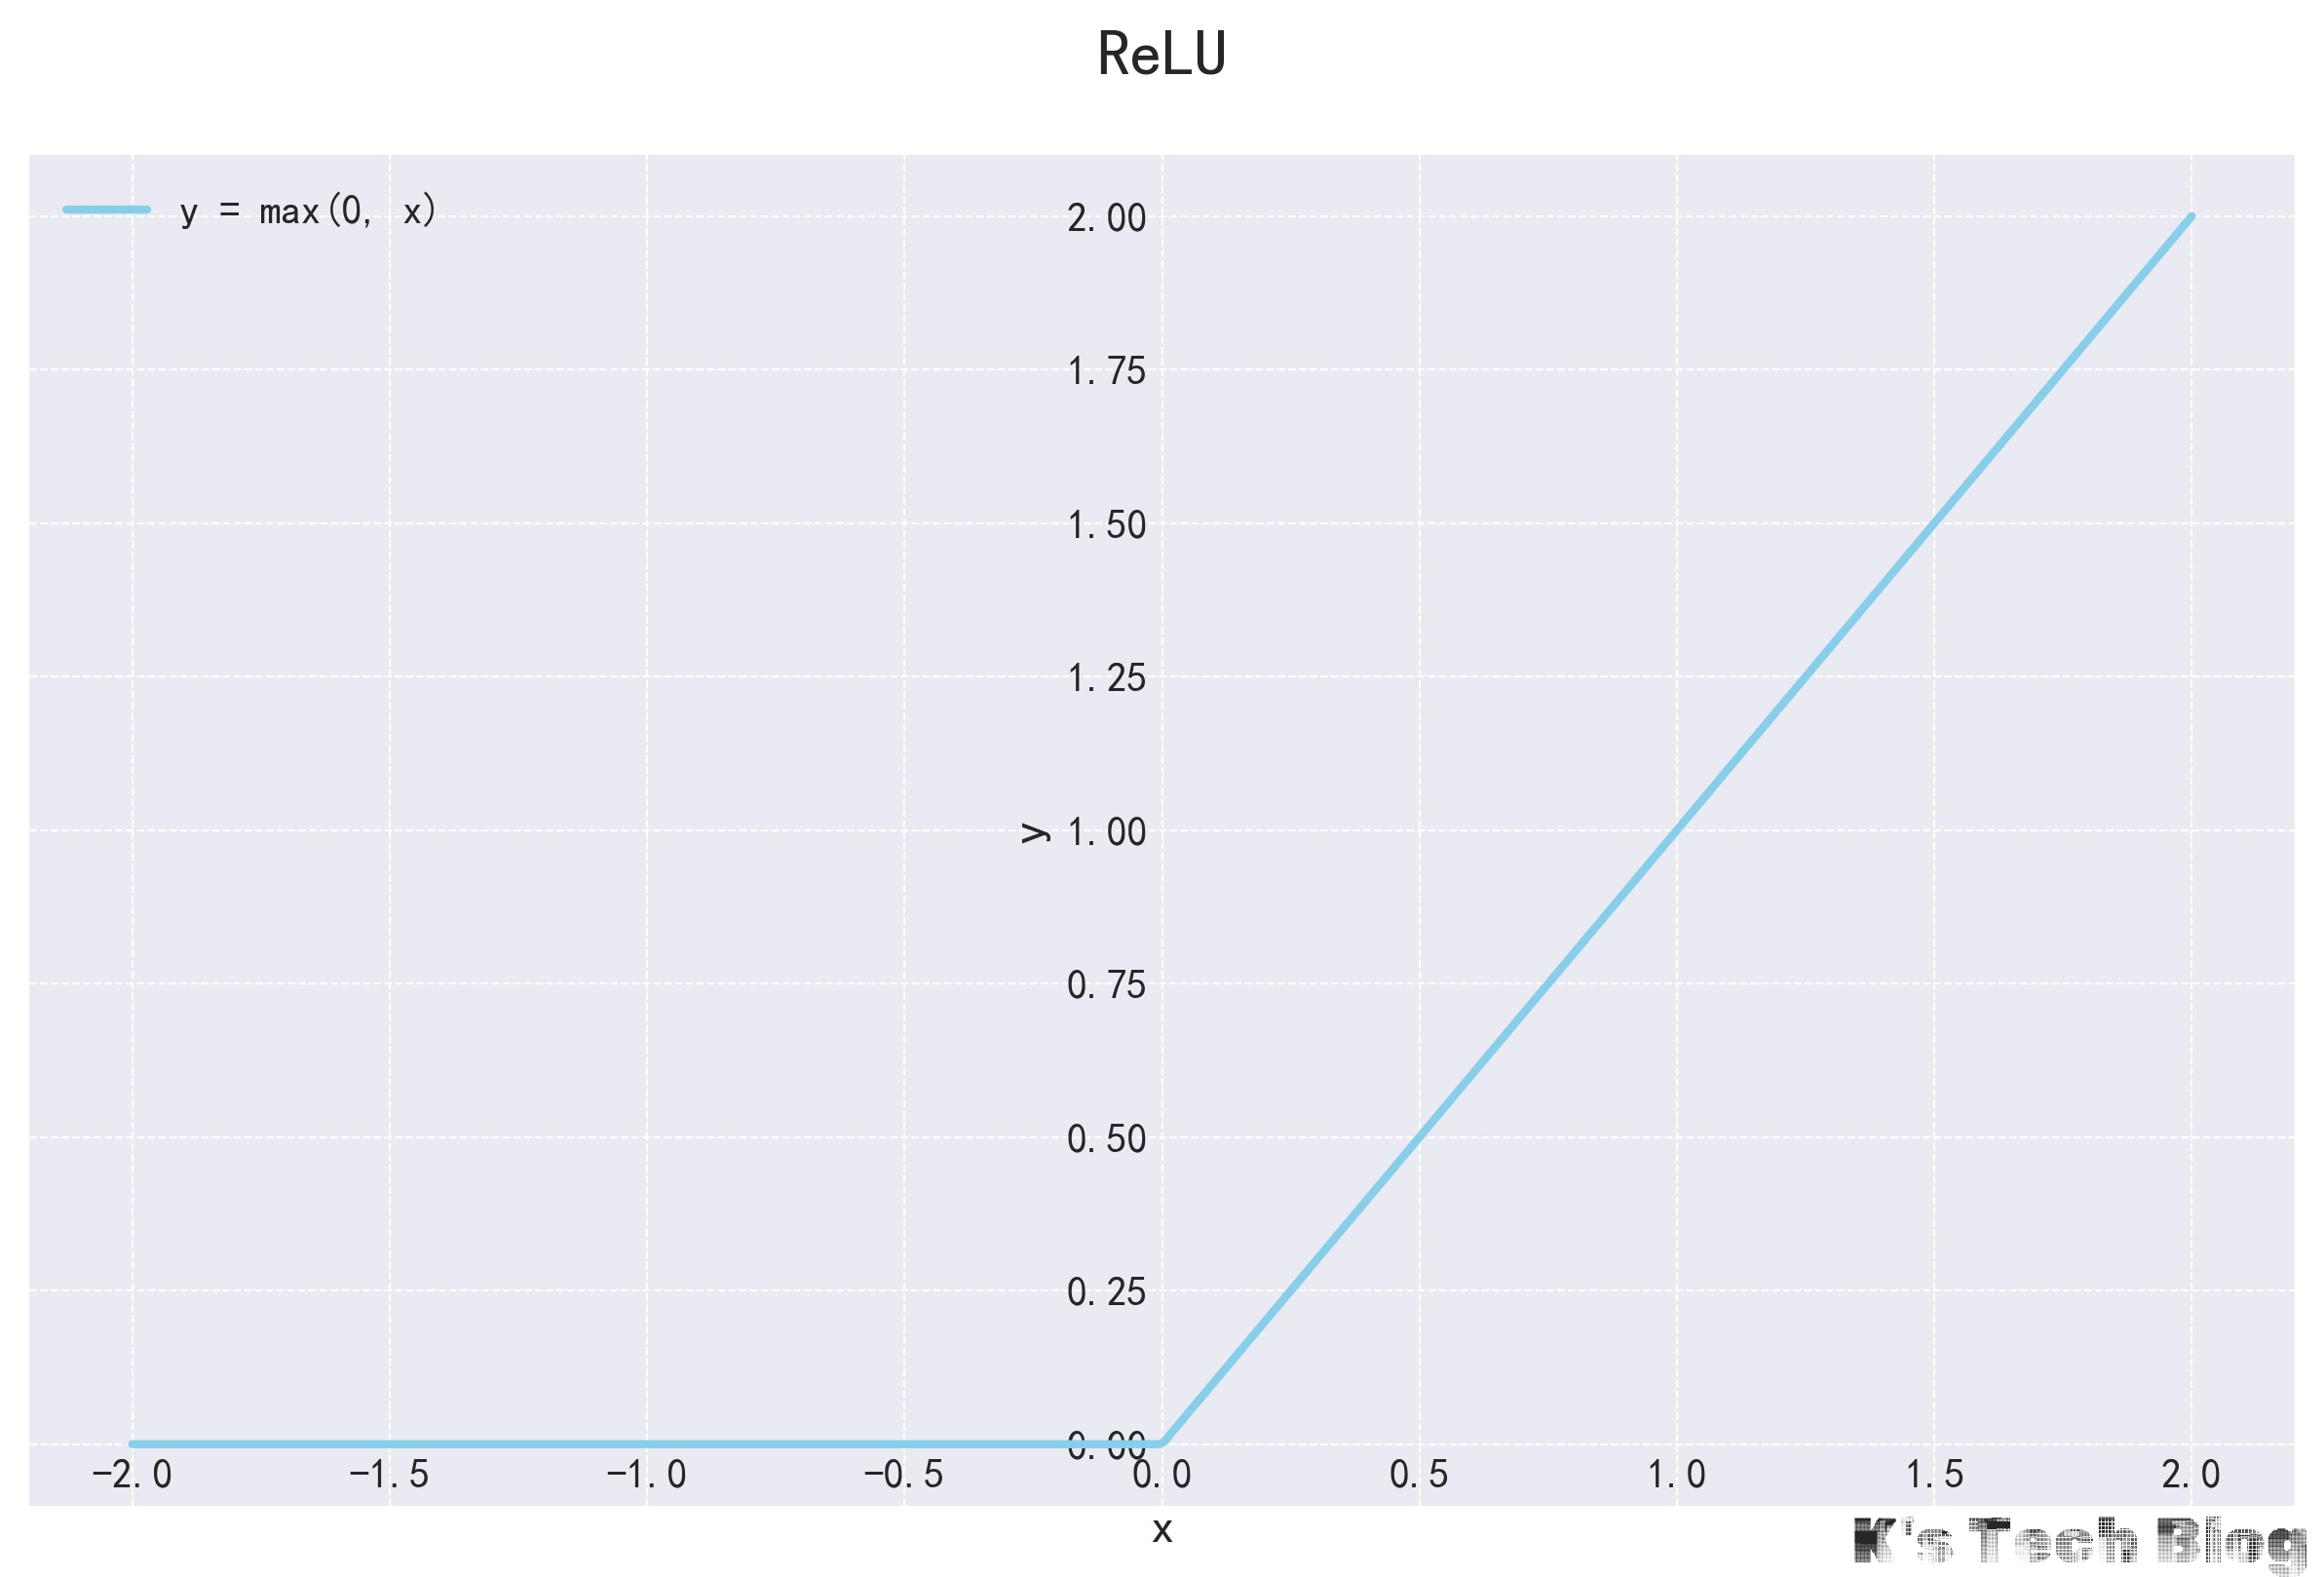
ReLU
Swish & SiLU
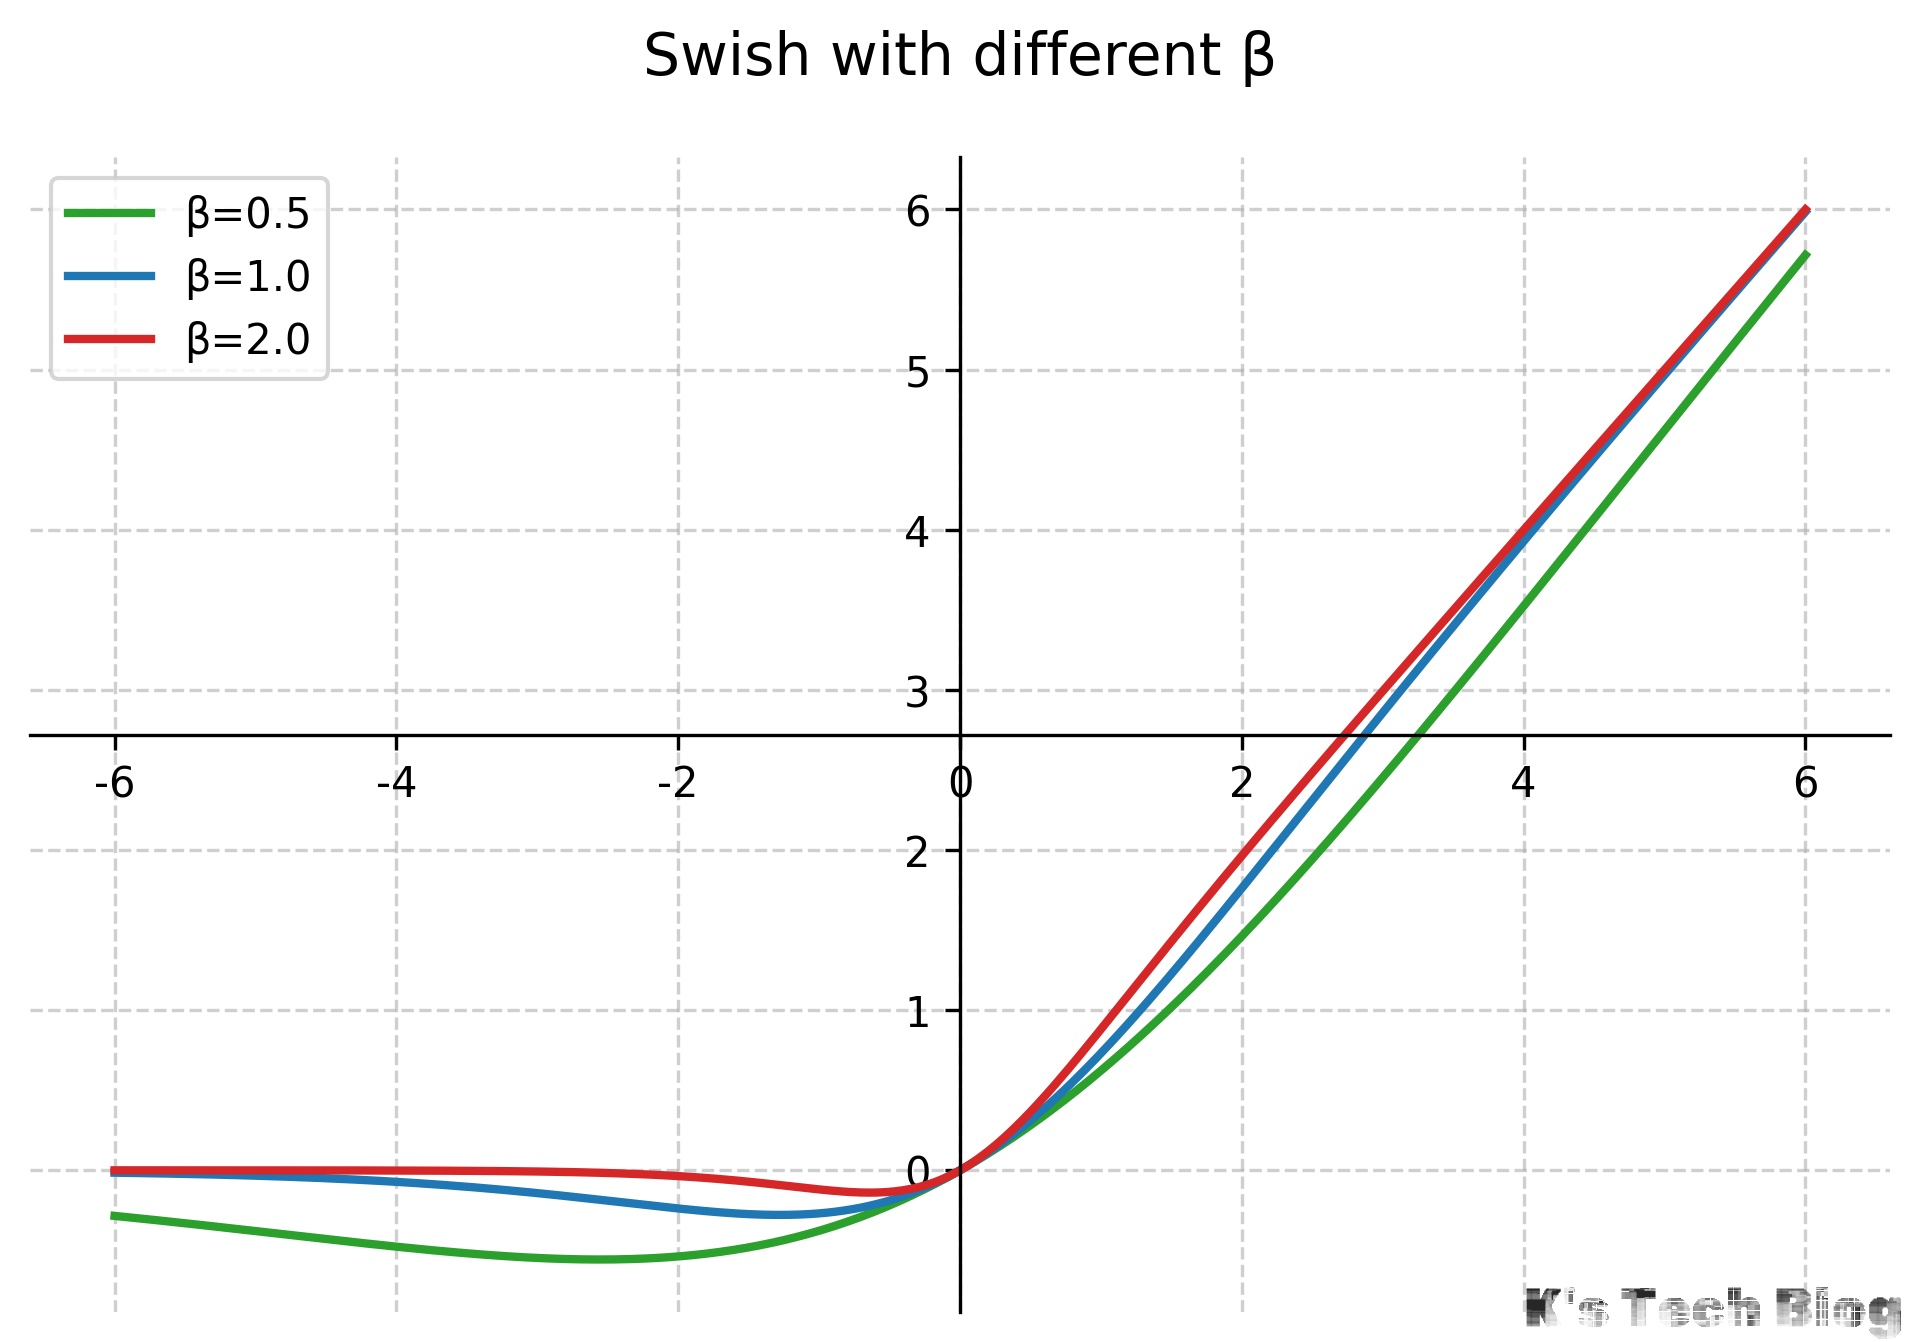
Swish函数由Google Brain团队提出,是一种自门控(Self-Gated)激活函数。
其中$\sigma$是Sigmoid函数,$\beta$是一个可学习参数或常数。
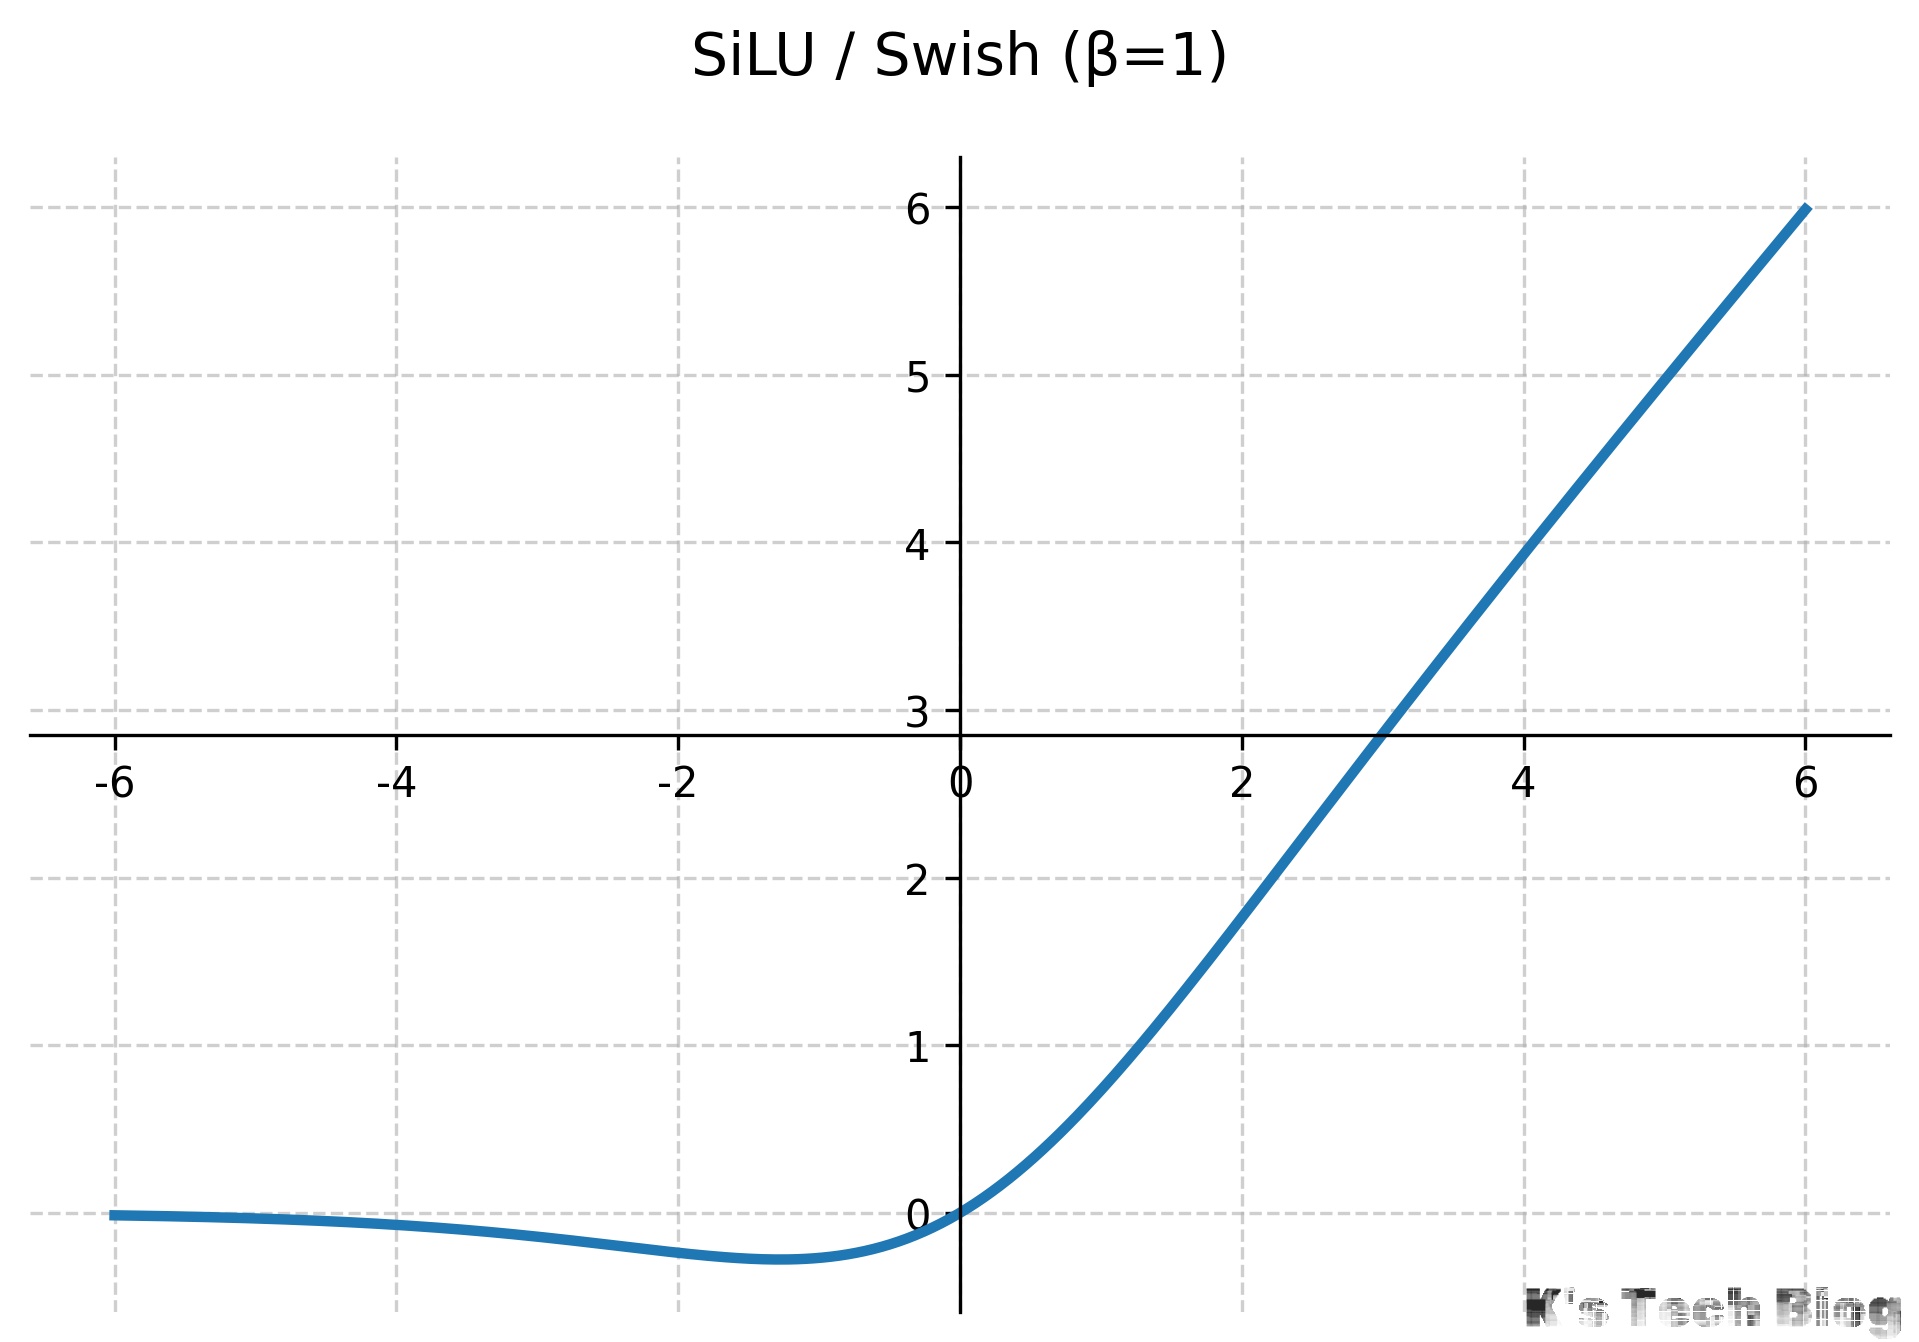
当$\beta = 1$时,Swish函数变为SiLU (Sigmoid Linear Unit):
$$ SiLU(x) = x \cdot \sigma(x) = \frac{x}{1 + e^{-x}} $$- 特点:
- 平滑且非单调:与ReLU不同,Swish在负值区域并在接近0时有非单调性,这有助于梯度的流动。
- 无上界,有下界:类似于ReLU,避免了梯度饱和,同时对负值有正则化效果。
- 在深层模型中通常优于ReLU。
SwiGLU
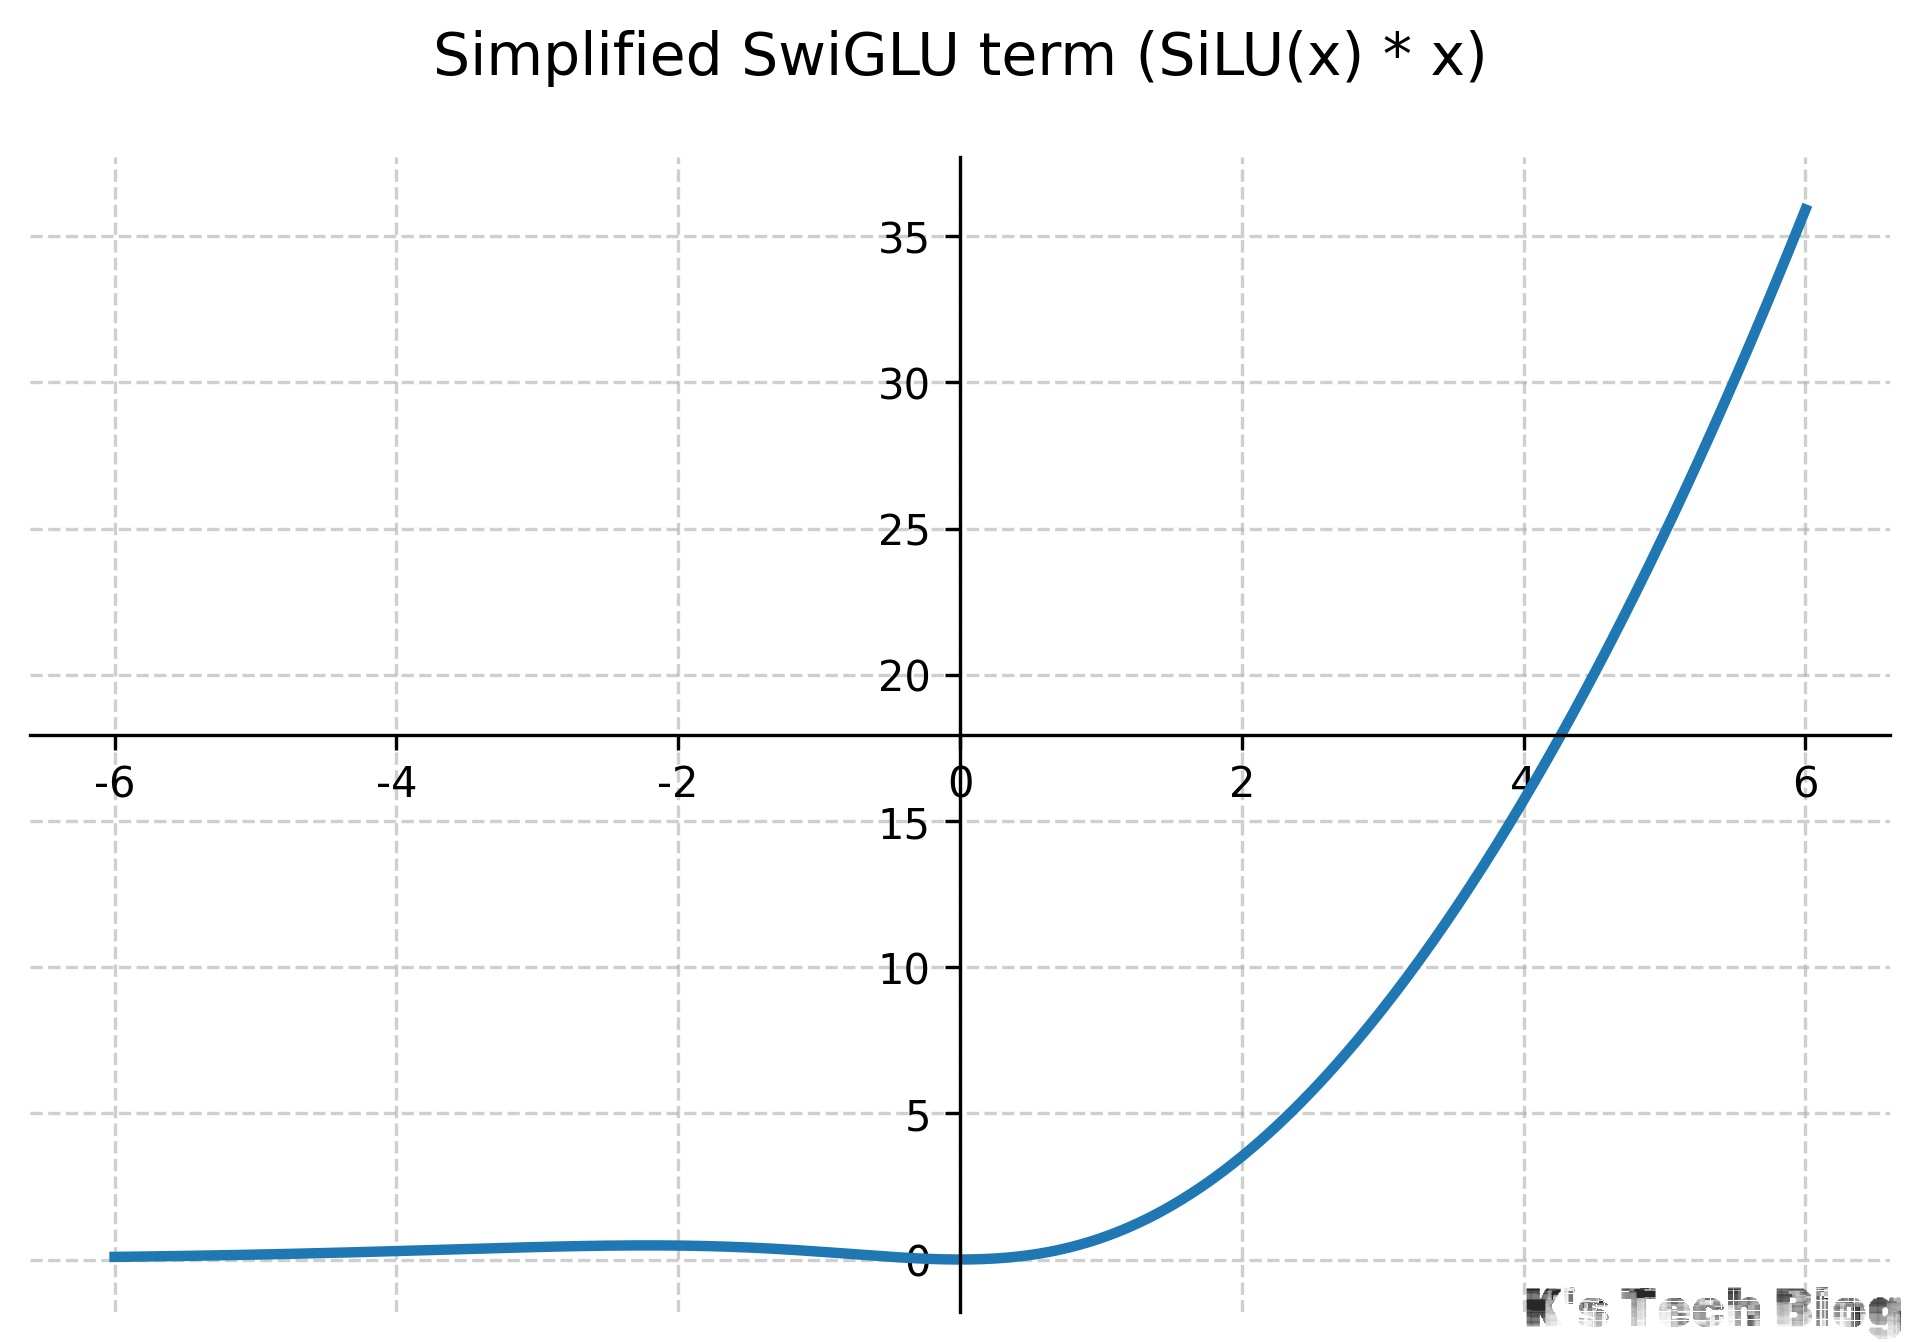
SwiGLU (Swish-Gated Linear Unit) 是在论文《GLU Variants Improve Transformer》中被提出并在大模型(如LLaMA, PaLM)中广泛使用的激活结构。它是GLU(Gated Linear Unit)的一种变体。
GLU定义为:
$$ GLU(x, W, V, b, c) = \sigma(xW + b) \otimes (xV + c) $$SwiGLU则是将Sigmoid激活函数替换为Swish(通常是$\beta=1$的SiLU),并通常省略Bias:
$$ SwiGLU(x, W, V) = Swish_{\beta}(xW) \otimes (xV) $$在Transformer的FFN层中应用SwiGLU通常如下(输入$x$):
$$ FFN_{SwiGLU}(x) = (SiLU(xW_1) \otimes xW_2)W_3 $$其中$W_1, W_2$将输入映射到隐藏层维度,$W_3$映射回原来的维度。
- 优势:相比标准的ReLU或GELU前馈网络,SwiGLU通常能带来更好的性能和收敛速度。
GELU
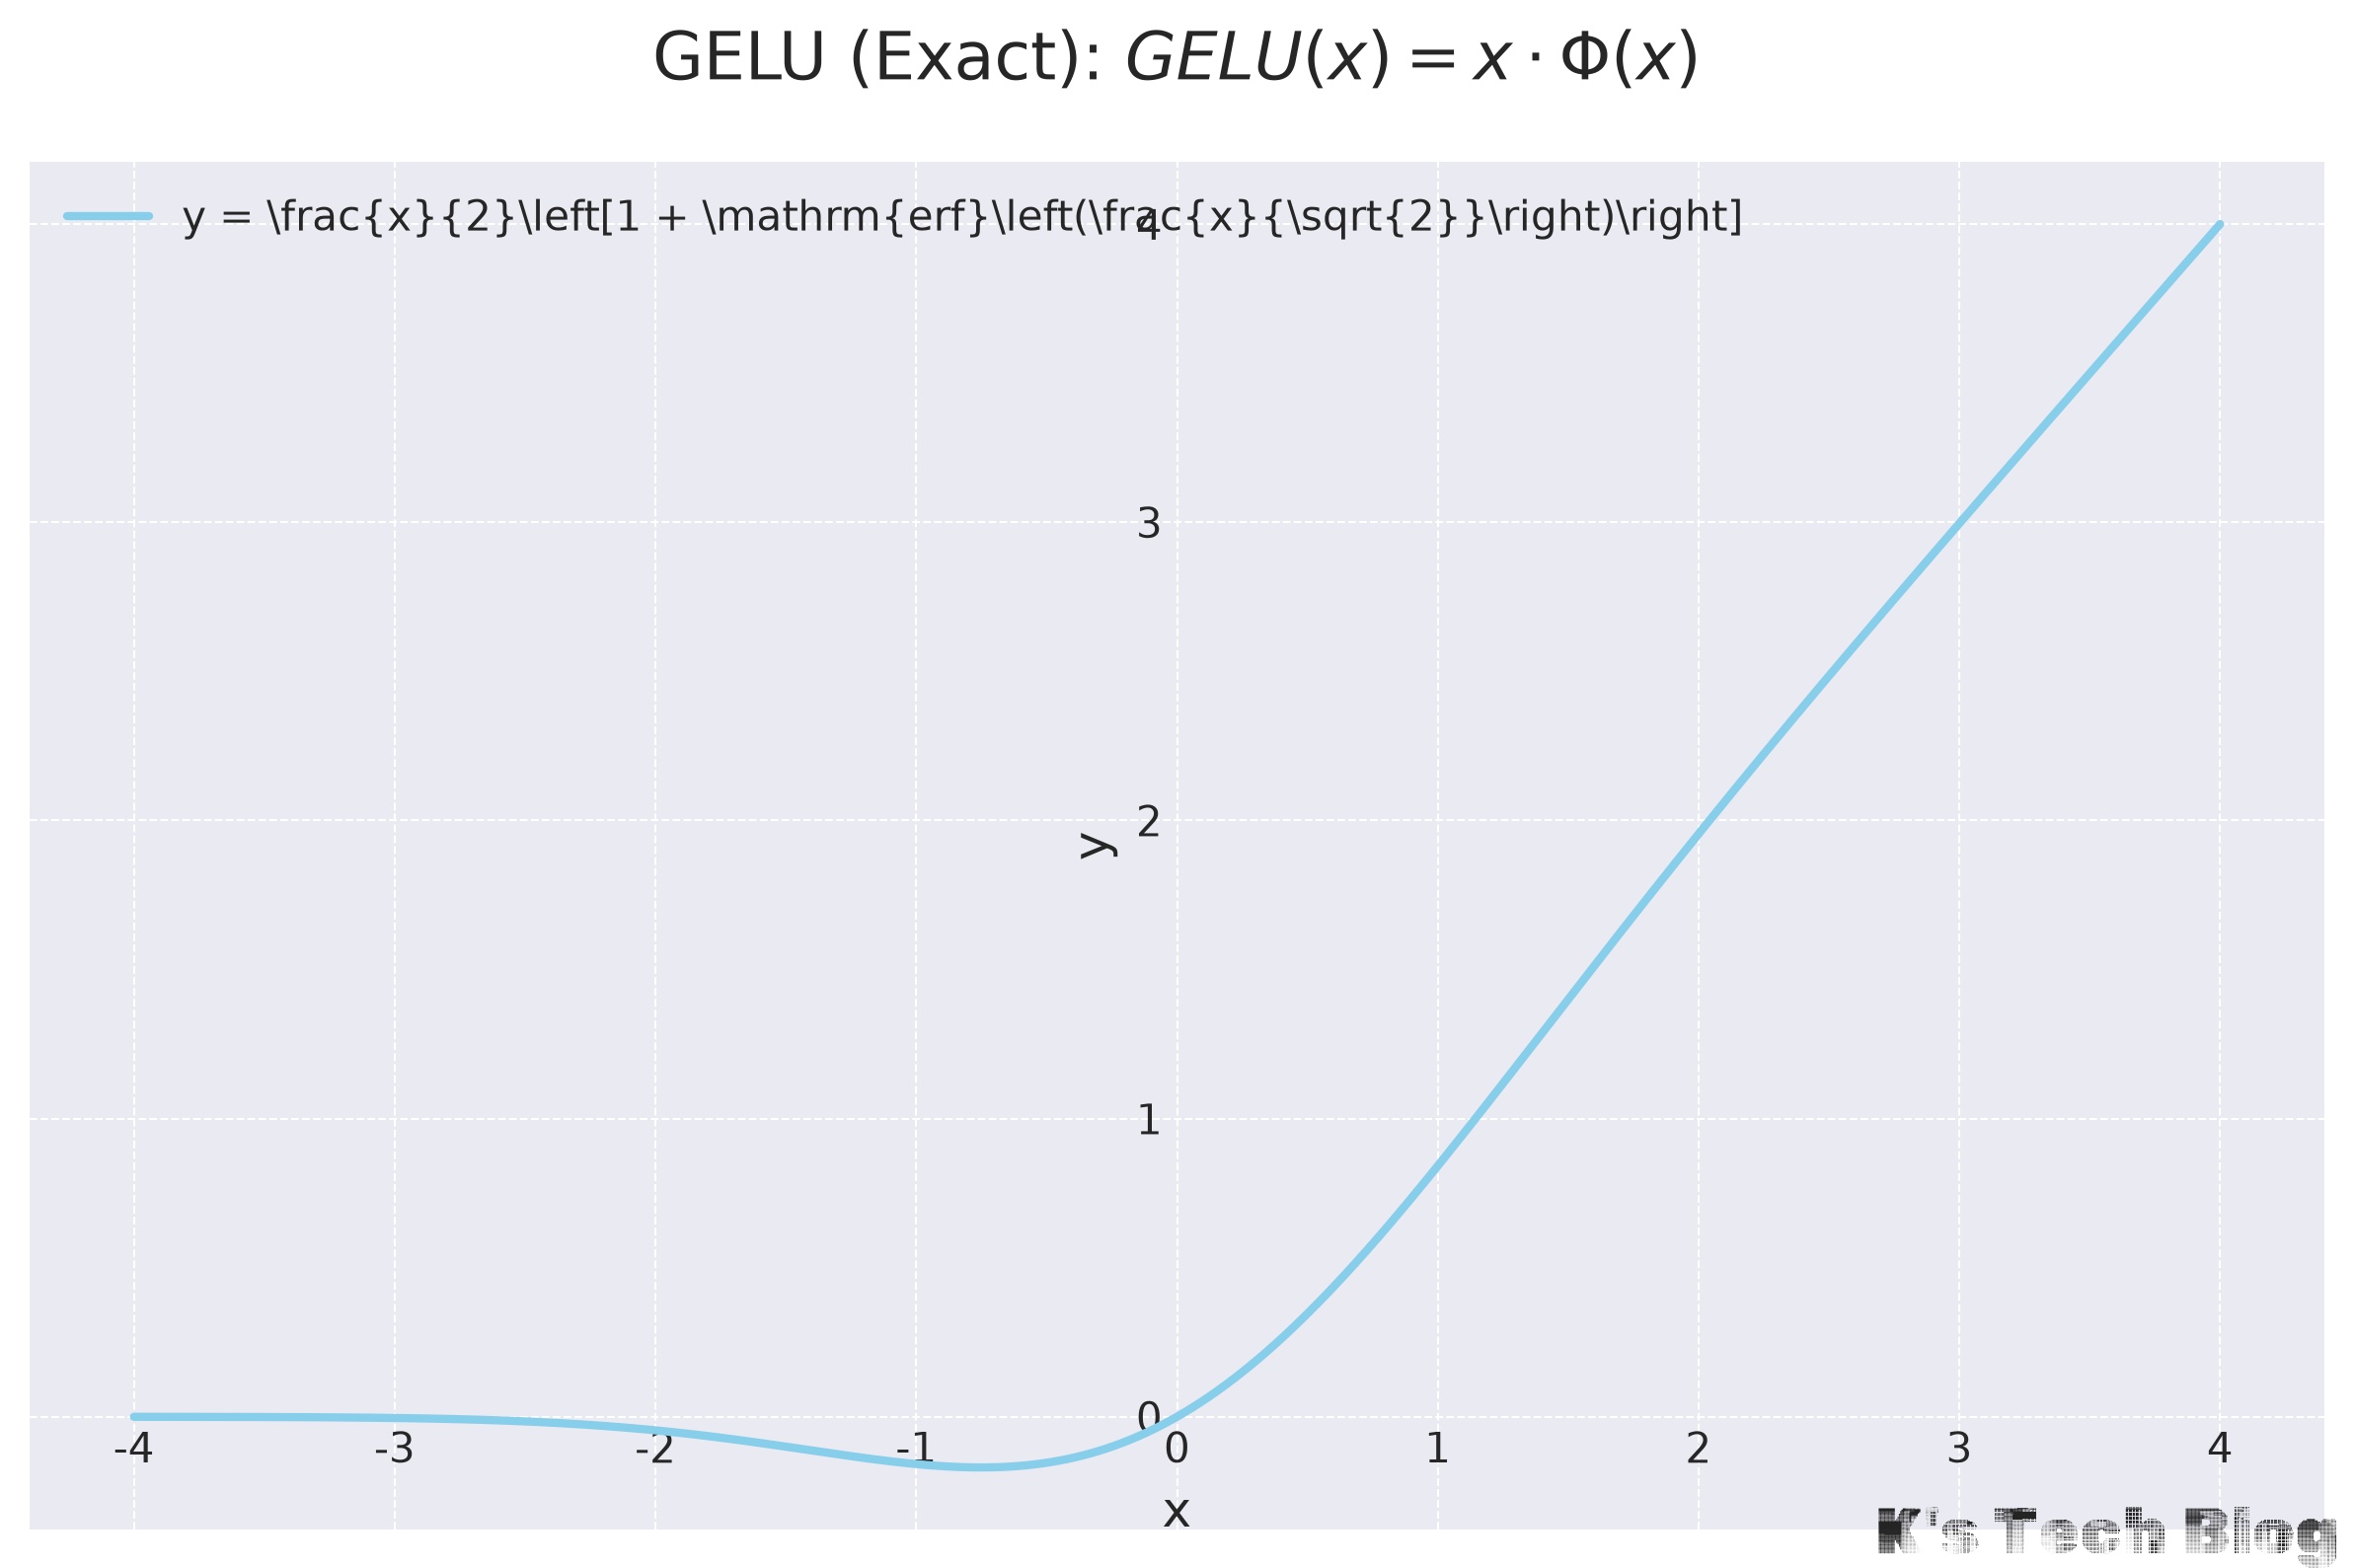
GELU(Gaussian Error Linear Unit),高斯误差线性单元,由 Dan Hendrycks 和 Kevin Gimpel 在 2016 年的论文《Gaussian Error Linear Units (GELUs)》中提出。它是 BERT、GPT、GPT-2、GPT-3、ViT 等众多 Transformer 模型默认使用的激活函数。
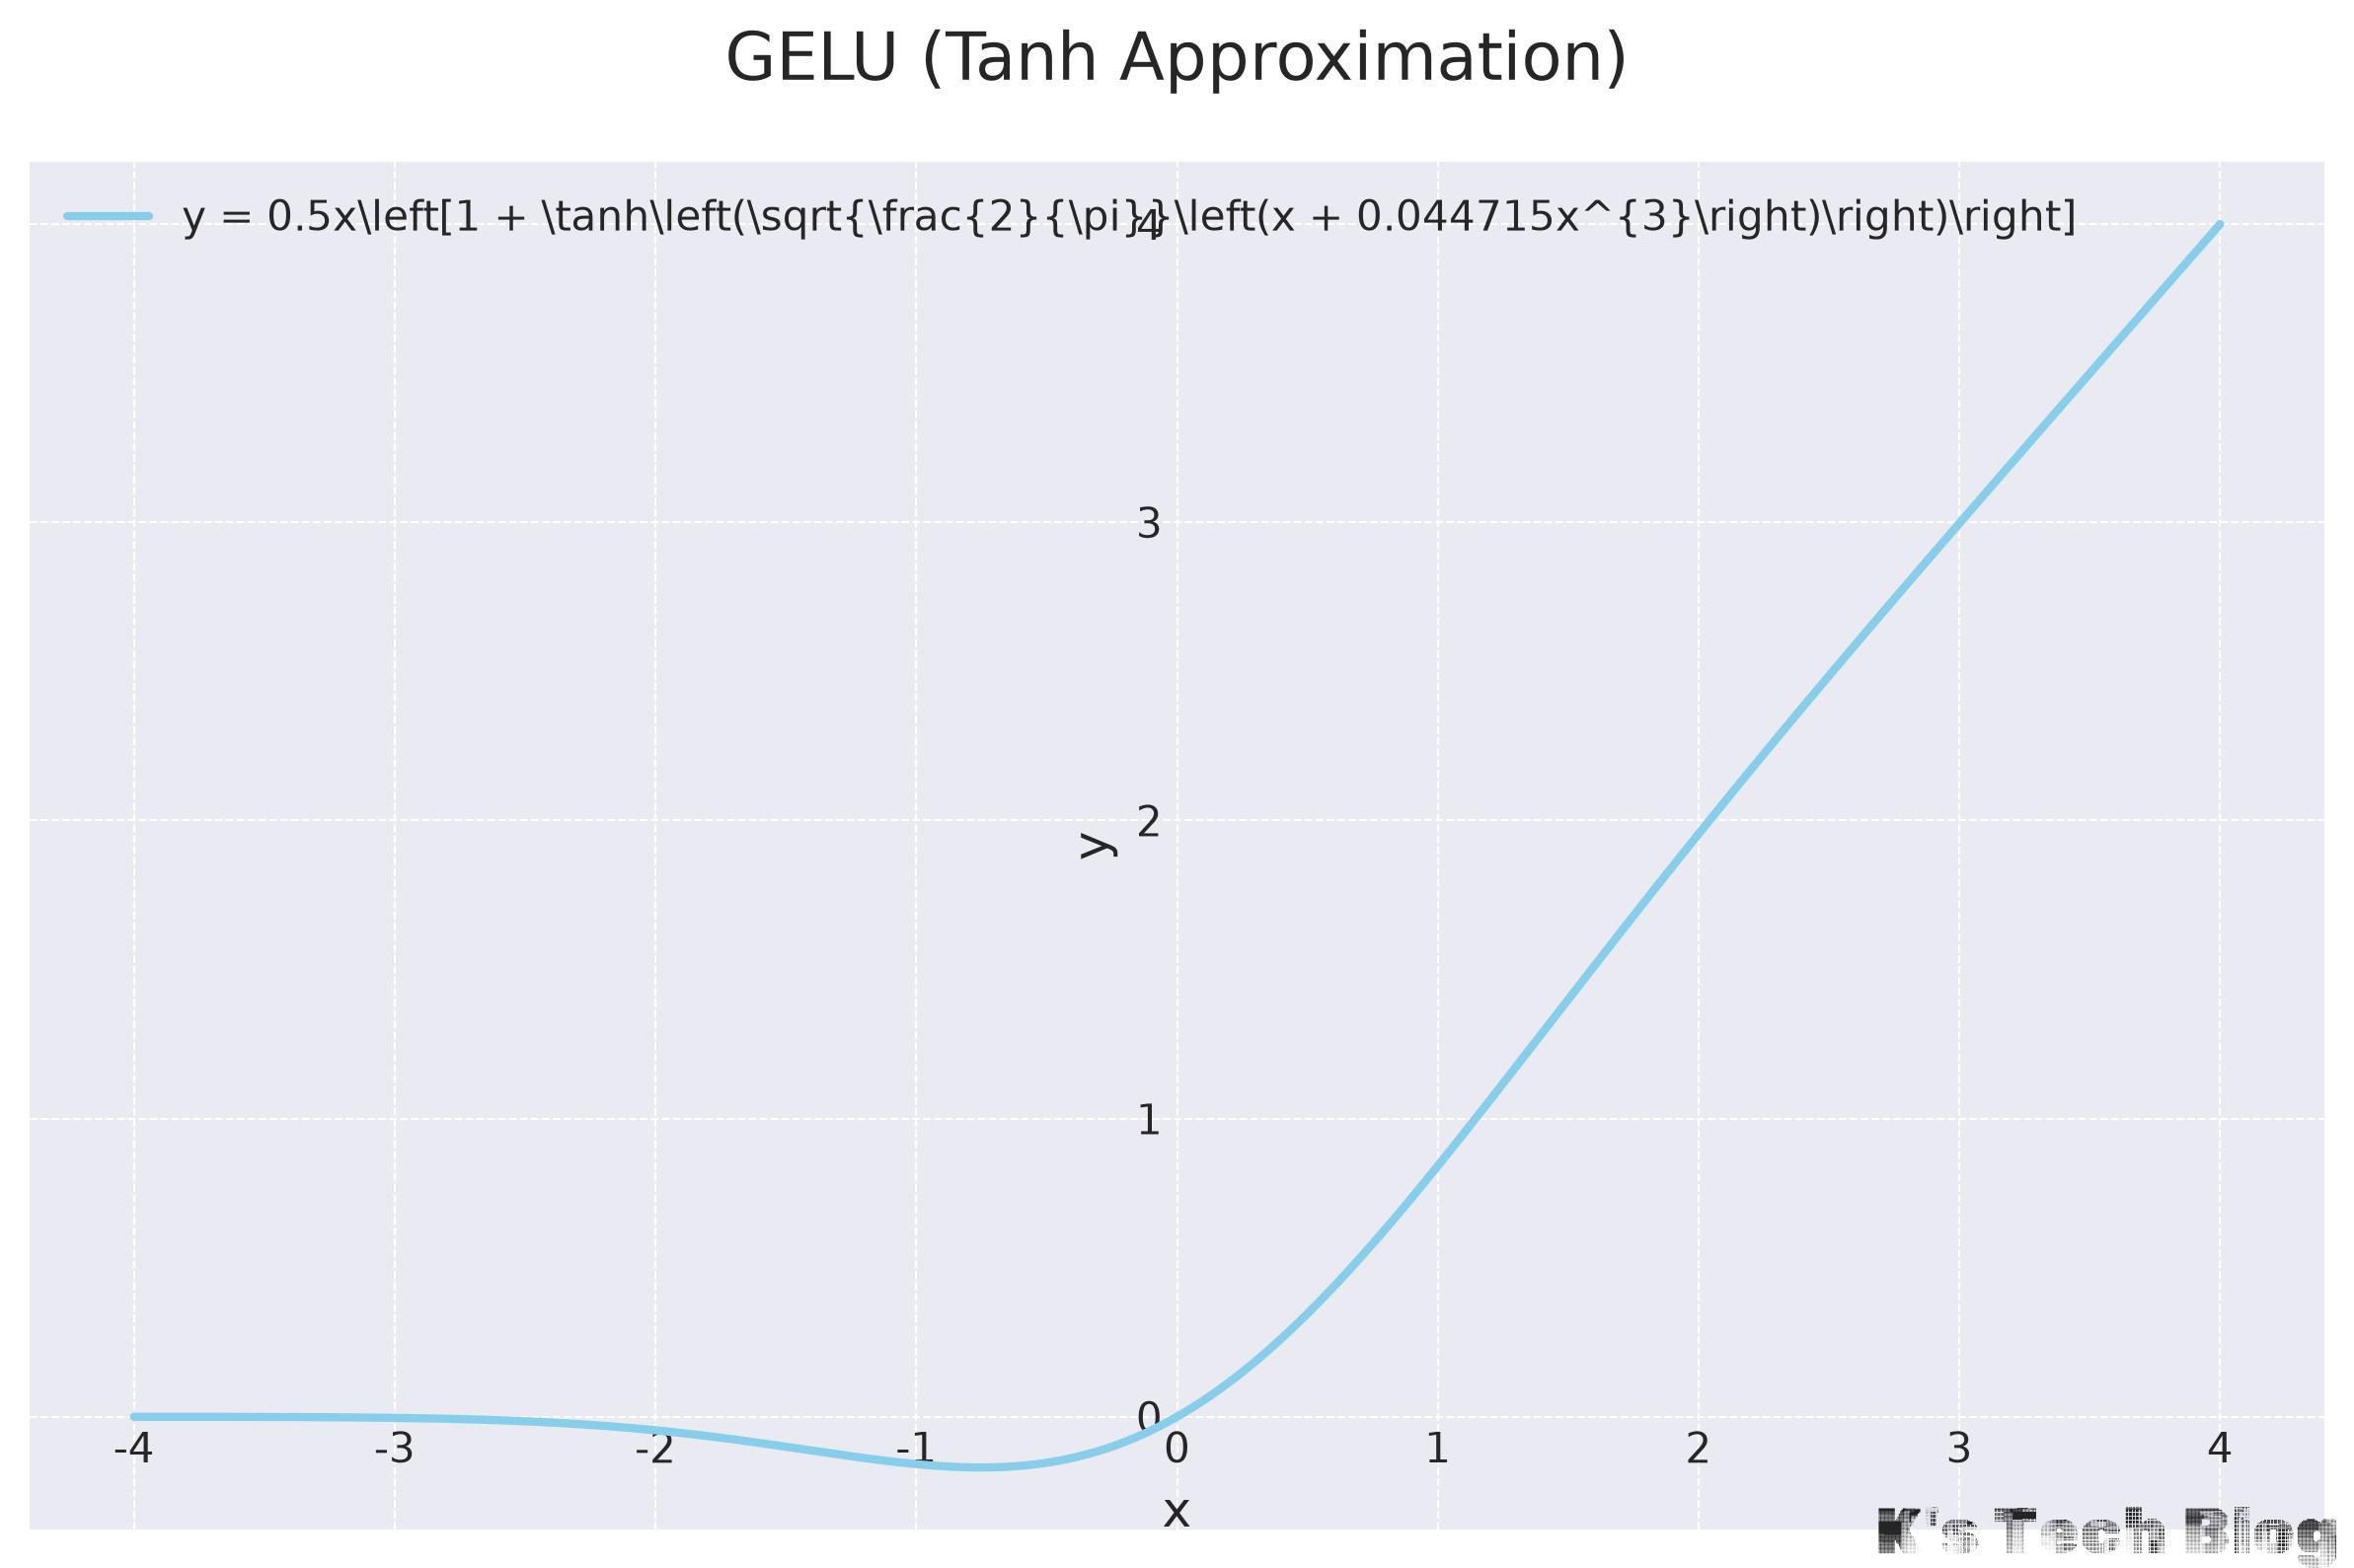
精确公式
GELU 的核心思想是将输入 $x$ 乘以一个 0~1 之间的权重,这个权重由 $x$ 自身的值依概率确定。形式上,它将输入与标准正态分布的累积分布函数 $\Phi(x)$ 相乘:
$$ GELU(x) = x \cdot \Phi(x) $$其中 $\Phi(x)$ 是标准正态分布 $N(0, 1)$ 的 CDF:
$$ \Phi(x) = \frac{1}{2}\left[1 + \text{erf}\left(\frac{x}{\sqrt{2}}\right)\right] $$所以精确形式可写为:
$$ GELU(x) = \frac{x}{2}\left[1 + \text{erf}\left(\frac{x}{\sqrt{2}}\right)\right] $$近似公式
由于 $\text{erf}$ 计算较慢,实际工程(如 OpenAI GPT、BERT)中通常使用 tanh 近似形式:
$$ GELU(x) \approx 0.5x\left[1 + \tanh\left(\sqrt{\frac{2}{\pi}}\left(x + 0.044715x^{3}\right)\right)\right] $$- 特点:
- 概率门控:不同于 ReLU 的硬性
max(0, x),GELU 根据输入的大小以概率方式决定激活程度,输入越大越倾向于完整通过。 - 平滑且非单调:函数全程可微,导数连续;在 $x \approx -0.75$ 附近存在一个小的“下沉”,即负值区域并非单调下降。
- 无上界,有下界:正半轴趋于线性($\approx x$),负半轴下界约为 $-0.17$,避免了 Sigmoid/Tanh 的梯度饱和问题。
- 可视为 Dropout + Zoneout + ReLU 的综合:将神经元输入乘以一个服从 Bernoulli $(\Phi(x))$ 的 mask,这个 mask 不是固定的 0/1,而是随机依赖于输入本身,把"随机正则化"思想融入了激活函数本身。
- 概率门控:不同于 ReLU 的硬性
- 典型应用:
- BERT、RoBERTa、GPT、GPT-2/3/4、ViT、Whisper 等几乎所有主流 Transformer 的 FFN 层默认激活函数。
- 在 NLP、CV、Speech 等大规模预训练任务中通常优于 ReLU 和 ELU。